Vision und Identität
Code: backend/src/justai/vision/, backend/src/justai/identity/,
Modelle über das Plugin vision-opencv.
Pipeline (ressourcenschonend)
Abschnitt betitelt „Pipeline (ressourcenschonend)“go2rtc-Substream ─► ffmpeg (fps pro Kamera, Standard 2) ─► Privatsphärenmaske ─► Bewegungserkennung ─► Objekterkennung YOLOX – nur bei Bewegung, aktiven Tracks oder alle heartbeat_s (20 s) ─► IoU-Tracker (pro Klasse, zeitbasiertes Altern) ─► Gesichtsprüfung YuNet + SFace auf Full-Res-Snapshot – nur für noch unbekannte Personen-Tracks ─► Events · Sichtungen (DB) · Watches · PTZ-Tracking-Listener- Ein Detektor und ein Gesichtsmodell für alle Kameras, Inferenz in einem begrenzten Thread-Pool (2 Worker).
- Während Gesprächen sinkt die Hintergrund-Bildrate (
background_slowdown). PTZ-Tracking schaltet für seine Kamera die Analyse jedes Frames ein. - Räume mit
vision_allowed: falsewerden nicht analysiert, mitface_recognition_allowed: falsegibt es dort keine Gesichtserkennung.
Konfiguration pro Kamera
Abschnitt betitelt „Konfiguration pro Kamera“Admin-UI → Vision (PUT /api/vision/cameras/{device_id}):
| Feld | Standard |
|---|---|
enabled |
true |
fps |
2 (0,2–10) |
motion, objects, faces |
true |
labels |
person, dog, cat, car, truck, bicycle, motorcycle, bird |
min_score |
0,5 |
privacy_zones |
Polygone (normalisierte Koordinaten); werden vor jeder Analyse geschwärzt |
heartbeat_s |
20 |
Wann gilt jemand als „gesehen“?
Abschnitt betitelt „Wann gilt jemand als „gesehen“?“Der Objektdetektor läuft nur bei Bewegung oder alle 20 s. Sitzt jemand still, bricht sein Track zwischen zwei Durchläufen ab (nach 4 s ohne Treffer) und wird kurz darauf neu erkannt. Deshalb gilt:
vision.person.recognizedwird pro Person höchstens alle 2 Minuten gemeldet.- Das Event enthält
away_s: Sekunden seit die Person zuletzt auf irgendeiner Kamera identifiziert war (nach einem Neustart aus den gespeicherten Sichtungen; nie gesehen = ein Jahr). Damit unterscheiden Automationen „ist zurückgekommen“ von „saß die ganze Zeit da“.
vision.motion.started/ended, vision.object.appeared/left,
vision.person.recognized (biometrisch, hohe Priorität), vision.face.unknown,
vision.watch.triggered, vision.state.changed.
Tools für den Assistenten
Abschnitt betitelt „Tools für den Assistenten“| Tool | Zweck |
|---|---|
vision.look |
Schnappschuss der Kamera im Raum (oder benannt) an das Vision-Modell: „Was siehst du?“ |
vision.detect |
lokale Objekterkennung auf dem aktuellen Bild |
vision.where_is |
letzte Sichtung einer Person/eines Tieres/Objekts (aus den Sichtungen) |
vision.watch / vision.unwatch |
Überwachungsaufgabe: „Sag mir, wenn ein Auto in die Einfahrt fährt“ (optional zeitlich begrenzt). Bei Auslösung Durchsage im Raum, in dem der Auftrag gegeben wurde. |
vision.state_teach / vision.state_get |
lernbare Zustände („Das Garagentor ist jetzt offen“), siehe unten |
vision.search_area |
mit PTZ-Kamera ein Gebiet absuchen (PTZ.md) |
Bilder gehen nur an Cloud-Modelle, wenn die Privacy-Regeln es erlauben
(camera_images_to_cloud global und cloud_media_allowed im Raum). Sonst wird ein
lokales Vision-Modell aus der Rolle vision verwendet oder die Anfrage abgelehnt.
Lernbare Zustandsdetektoren
Abschnitt betitelt „Lernbare Zustandsdetektoren“Für feste Kameras: Ein Detektor beobachtet eine Region (z. B. das Garagentor).
Der Benutzer zeigt Beispiele, indem er den aktuellen Zustand benennt; mehrere
Referenzen pro Zustand sind möglich (Tag/Nacht). Die Klassifikation ist ein
Nächster-Nachbar-Vergleich auf normalisierten, verkleinerten Graustufen-Ausschnitten.
Dafür braucht es kein Training und keinen neuen Code. Zustandswechsel erzeugen
vision.state.changed und können Automationen auslösen.
Grenzen: Starke Lichtwechsel ohne passende Referenz führen zu falschen Zuständen. Deshalb Referenzen bei verschiedenen Lichtverhältnissen anlegen.
Personen, Tiere, Gesichter
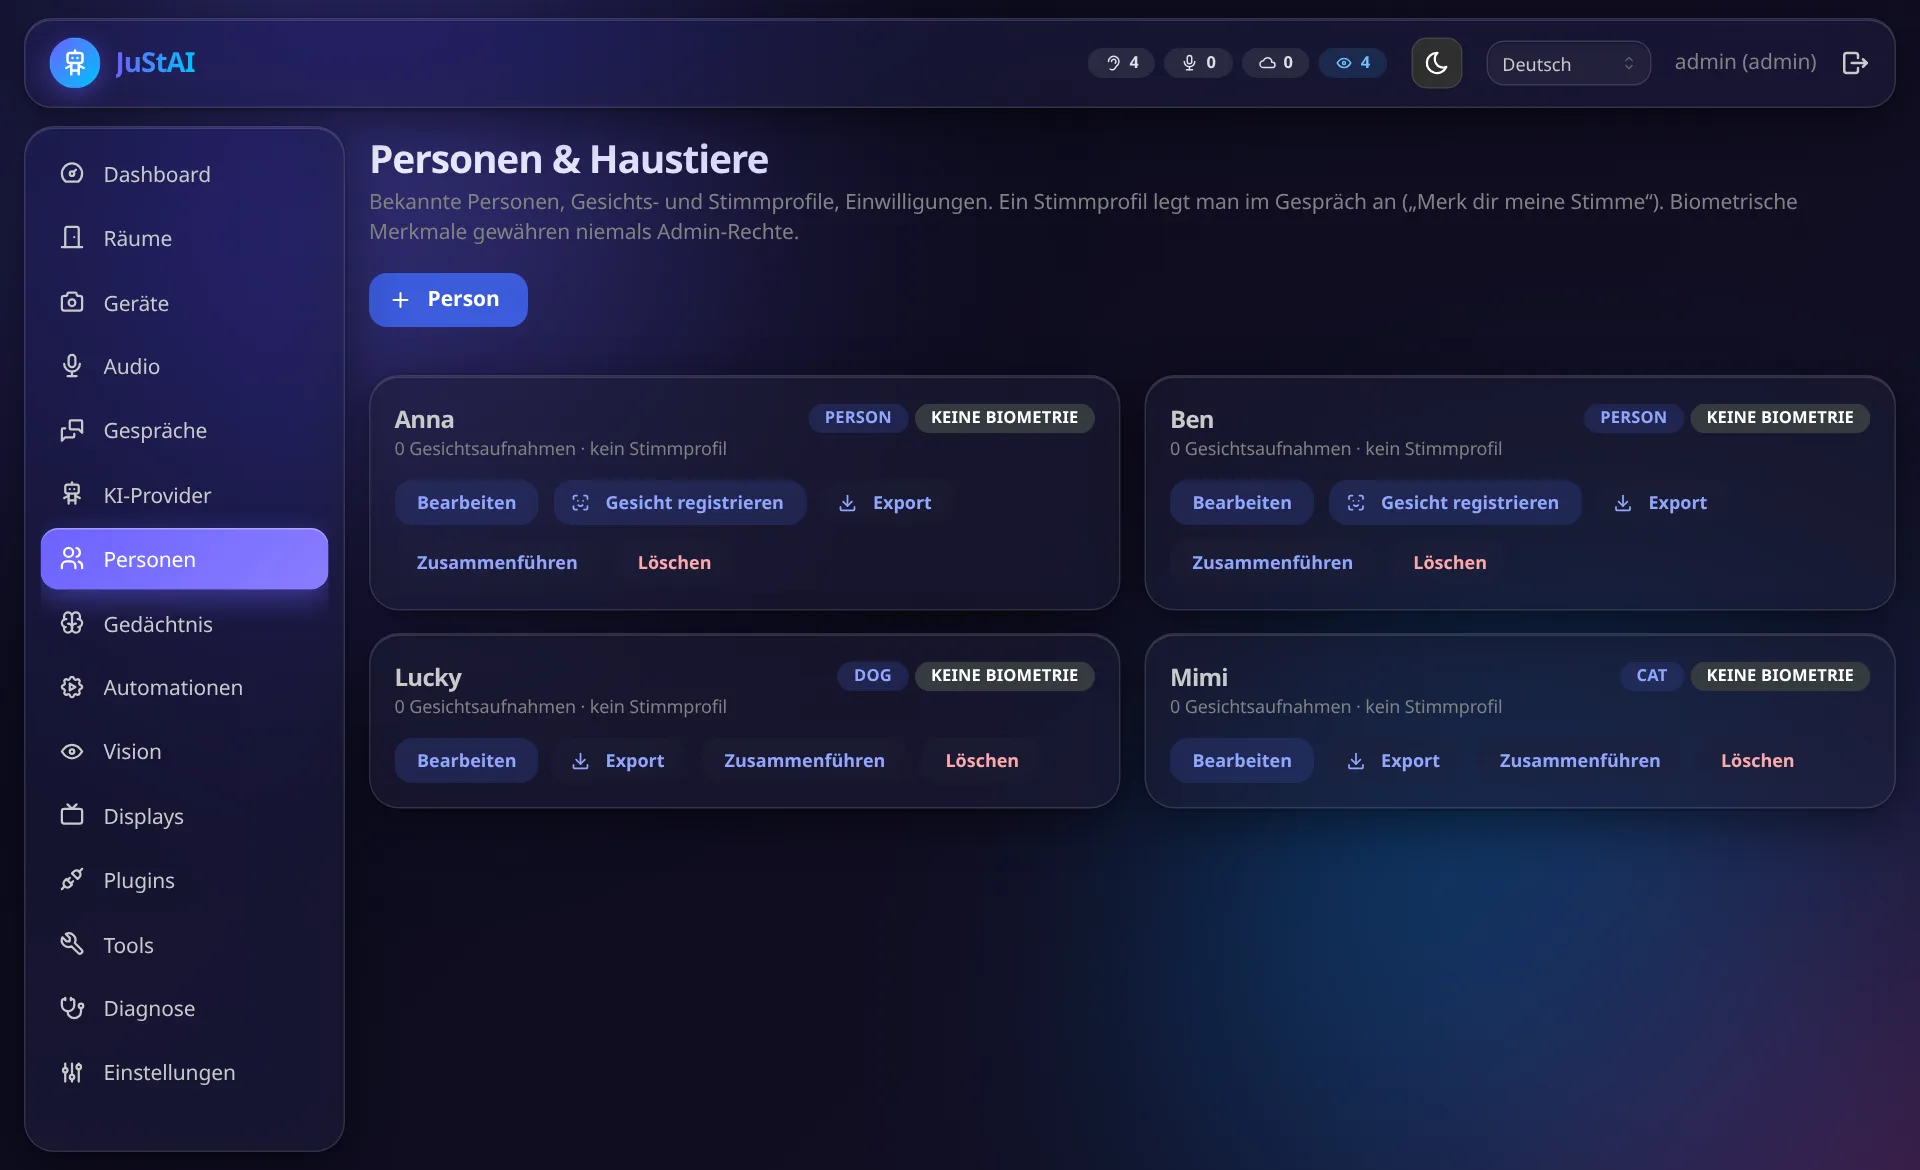
Abschnitt betitelt „Personen, Tiere, Gesichter“Personen und Haustiere werden in der Admin-UI unter Personen verwaltet oder
im Gespräch angelegt („Ich bin Julian“, Tool identity.introduce).
Biometrie nur mit Einwilligung.
- Gesichts-Embeddings werden nur gespeichert, wenn für die Person eine Einwilligung
(Art
face) mit Nachweis (wer, wann, wie) erfasst ist. - Das Tool
identity.register_faceerfordert eine ausdrückliche mündliche Bestätigung (requires_confirmation) und das Rechtbiometric.enroll. - Registrierung prüft die Qualität: Gesichtsgröße ≥ 70 px, Schärfe, Frontalität. Nahezu identische Aufnahmen werden nicht doppelt gespeichert.
- Widerruf der Einwilligung oder Löschen der Person entfernt alle biometrischen
Daten (Embeddings, Thumbnails). Personen lassen sich exportieren
(
GET /api/people/{id}/export) und zusammenführen.
Wiedererkennung:
- SFace-Kosinus-Ähnlichkeit: ab 0,40 „schwach“, ab 0,52 „stark“ (konfigurierbar im Plugin). Das ist keine kalibrierte Wahrscheinlichkeit und wird nirgends als Prozentwert ausgegeben.
- Ein Track gilt als erkannt bei einem starken Treffer oder bei zwei schwachen Treffern für dieselbe Person.
- Biometrie personalisiert (Ansprache, eigene Erinnerungen), gewährt aber nie
Administratorrechte (
auth/rbac.py). - Haustiere: Gibt es genau ein registriertes Tier einer Art, wird ein erkannter Hund oder eine erkannte Katze diesem Tier zugeordnet (Annahme, als solche gekennzeichnet).
Stimmprofile
Abschnitt betitelt „Stimmprofile“Neben dem Gesicht kann eine Person auch an der Stimme erkannt werden: Das Gesicht zeigt, wer im Raum ist, die Stimme, wer gerade spricht.
- Anlegen im Gespräch: „Merk dir meine Stimme“ (Tool
identity.register_voice, Bestätigungspflicht, Rechtbiometric.enroll). Der Assistent nutzt das in diesem Gespräch Gesprochene (mindestens 4 s; sonst bittet er um ein paar Sätze mehr) und speichert daraus mehrere Stimmproben (Embeddings, keine Aufnahmen; max. 10 pro Person, die neuesten bleiben). Einwilligung „voice“ wird mit Nachweis erfasst. - Erkennung: am „Hey Justy“ zu Beginn jedes Gesprächs; reicht das nicht, noch einmal nach ~3 s Sprache. Ein Name wird nur genannt bei Ähnlichkeit ≥ 0,55 und Abstand ≥ 0,08 zur nächstbesten Person. Die Stimme hat Vorrang vor der Kamera.
- Löschen: „Vergiss meine Stimme“ (
identity.forget_voice), Personen → Stimmprofil löschen, Widerruf der Einwilligung oder Löschen der Person entfernen alle Proben. Zusammenführen überträgt sie, Export enthält sie. - Ein erkanntes Gesicht oder eine erkannte Stimme personalisiert das Gespräch (eigene Erinnerungen, Ansprache), gibt aber nie Admin-Rechte. Eine Stimme lässt sich mit einer Aufnahme nachahmen; sie ist keine Authentifizierung.
Getestet
Abschnitt betitelt „Getestet“- Unit: Tracker, Bewegung, Privatsphärenmaske, Zustandsklassifikation,
Punkt-in-Polygon (
tests/unit/test_vision_logic.py). - Mit echter Kamera (C200): Snapshots und
vision.look(Gemini, mit Fallback aufgemini-flash-lite-latestbei Überlastung). Gesichtsregistrierung und -wiedererkennung mit der echten Kamera stehen noch aus, weil dafür eine Person vor der Kamera stehen muss. - E2E:
vision.person.recognized(eingespeist) löst eine Begrüßungs-Automation im richtigen Raum aus.