Audio: Echo, VAD, Wakeword, Arbitrierung, Duplex
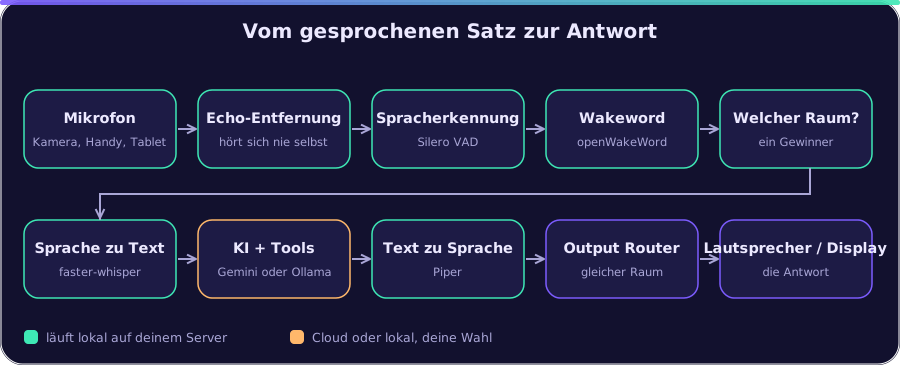
Wichtigste Anforderung: Der Assistent reagiert nie auf seine eigene Stimme. Netzwerkkameras als Mikrofon und Lautsprecher machen das schwer: Die Ausgabe kommt über go2rtc und den Kamera-Backchannel mit 1–2 s Verzögerung und schwankender Latenz wieder im Mikrofon an. Deshalb gibt es mehrere unabhängige Schutzschichten, nicht nur einen Echo-Canceller (ADR 0005).
Code: backend/src/justai/audio/.
Signalweg
Abschnitt betitelt „Signalweg“go2rtc (RTSP) ─► ffmpeg ─► 16 kHz mono s16le ─► SampleClock (Zeitstempel) ─► MicChannel ─► pro Endpoint: EndpointAudioProcessor (10-ms-Frames, eigener Thread) 1. Gain 2. Echo-Fenster? (PlaybackTracker: Wiedergabe-Bursts + Latenz + Nachhall) 3. WebRTC APM: HPF, AEC3 (Referenz um die gemessene Latenz verschoben), NS 4. Silero-VAD, Rauschboden, Sprachsegmentierung 5. Gating: Half Duplex → im Echo-Fenster alles verwerfen Full Duplex → nur durchlassen, wenn Double-Talk erkannt (Barge-in) 6. openWakeWord (mit Unterdrückung während der Wiedergabe) ─► Wake-Kandidaten ─► WakeArbiter ─► Gesprächssession ─► ProcessedFrame (gated-Flag) ─► Session (STT bzw. Realtime-Upload)
Antwort ─► Output Router ─► SpeakerChannel (Echtzeit-Pacing) ─► Sink: go2rtc-Talkback | Plugin-Senke ─► jedes ausgegebene Frame mit Ausgabezeitpunkt ─► ReferenceBuffer + PlaybackTrackerEigene Lautsprecher-Verbindung pro Gespräch: Eine Tapo-Kamera spielt nur die Sprech-Sitzung ab, die zuletzt geöffnet wurde. Früher blieb der Kanal zum Kameralautsprecher stundenlang auf der Hauptverbindung offen. Hatte zwischendurch ein anderer Client gesprochen (z. B. die Tapo-App), kamen weiter Bytes an der Kamera an, aber nichts war zu hören. go2rtc erneuert diese Sitzung nicht, solange das Video die Verbindung am Leben hält. Live beobachtet an der C200 (2026-10-20): Zustellung vollständig, nichts hörbar, auch nach go2rtc- und Kamera-Neustart; eine frisch geöffnete zweite Verbindung spielte sofort. Deshalb:
- Der Lautsprecher hat einen eigenen go2rtc-Stream
<stream>_talk(gleiche Quelle wie der Hauptstream, also eine eigene Kameraverbindung). Er wird bei jedem Öffnen neu angelegt: beim Wakeword (Vorwärmen), für Testtöne und Automationen. - Nach 90 s ohne Ausgabe wird er geschlossen und gelöscht
(
speaker_idle_close_spro Gerät überschreibbar). Damit ist die Sprech-Sitzung der Kamera auch wieder für die Tapo-App frei. - Der Tapo-Login der neuen Verbindung dauert gemessen ca. 4 s. Bis dahin hält der
Core Sprache zurück (plus
talkback_settle_s, Standard 1,5 s), statt sie in die noch nicht verbundene Leitung zu schicken; der Anfang geht nicht verloren.
Zustellung prüfen statt annehmen: go2rtc holt den Audiostrom auch dann weiter ab, wenn die Verbindung zum Kameralautsprecher verloren ging (z. B. nach einem Kamera-Reconnect). Das Audio verschwand dann lautlos. Der Core fragt deshalb jede Sekunde bei go2rtc ab, ob tatsächlich Bytes an die Kamera gehen. Erst dann gibt er Sprache frei, und nach 6 s ohne Zustellung baut er die Strecke neu auf (bei offline-Kamera mit wachsendem Abstand bis 60 s). Eine frisch geöffnete Verbindung hat 20 s Zeit für den Login. Gezählt werden die Bytes an die Kamera auch dann, wenn go2rtc die Kameraverbindung als „Consumer“ führt (Stream nur für den Lautsprecher); sonst hielt der Wächter funktionierende Verbindungen für tot und baute sie ständig neu auf. Live geprüft: Nach „Neu verbinden“ der C200 war die Strecke nach ~15 s wieder da (8 KB/s an die Kamera, stabil).
Talkback zu Kameras: Der Core stellt pro Lautsprecher einen Live-WAV-Stream
bereit (/internal/talkback/<token>.wav, Token zufällig, nur im internen Netz).
go2rtc zieht ihn als Quelle in den Backchannel der Kamera
(POST /api/ffmpeg?dst=<stream>&live=<url>). Der Core taktet die Ausgabe selbst in
Echtzeit. Deshalb weiß er für jedes Frame, wann es ausgegeben wurde; das ist die
Echo-Referenz. Bricht der Pfad ab, wird er neu aufgebaut.
Schutzschichten gegen Selbstgespräche
Abschnitt betitelt „Schutzschichten gegen Selbstgespräche“| # | Schicht | Wo | Wirkt gegen |
|---|---|---|---|
| 1 | AEC3 mit Bulk-Delay-Kompensation | echo.py EchoCanceller + DelayEstimator |
Echo im Signal (Full Duplex) |
| 2 | Echo-Fenster + Half-Duplex-Gate: Solange eigene Ausgabe hörbar sein kann (Ausgabe + Latenz + Nachhall), wird das Mikrofon verworfen | PlaybackTracker, processor.py |
alles Echo, deterministisch |
| 3 | Wakeword-Unterdrückung während der Wiedergabe: Half Duplex: keine Wakewords im Echo-Fenster; Full Duplex: nur über threshold_during_playback (0,85) |
processor._run_wakeword |
Assistent sagt selbst „Hey Justy“ |
| 4 | Echo-Transkriptfilter: Ähnelt ein Benutzertranskript stark dem, was der Assistent in den letzten 25 s gesagt hat, wird es verworfen | conversation/echo_filter.py |
Restecho, das trotzdem transkribiert wurde |
| 5 | Wakeword-Nachlauf weglassen: Nach einer Pause beginnt die Session hinter der Pause; Äußerungen mit weniger als 200 ms Sprache startet die Pipeline gar nicht erst (Sprechen ohne Pause) | conversation/session.py |
„Jarvis“-Rest oder Hall wird als Frage interpretiert oder blockiert die Session |
| 6 | Inaktivitäts-Timeout startet erst nach Ende des Echo-Fensters | conversation/state.py |
Session endet nicht während der Ausgabe |
Zusätzlich: Der Echo-Fenster-Tracker merkt sich mehrere Ausgabe-Bursts, weil das Echo eines früheren Satzes noch unterwegs sein kann, während der nächste beginnt.
Messung: AEC3 und lange Verzögerungen
Abschnitt betitelt „Messung: AEC3 und lange Verzögerungen“WebRTC AEC3 schätzt die Verzögerung zwischen Referenz und Mikrofon nur in einem
begrenzten Bereich. Messung mit scripts/measure_aec.py (synthetisches
sprachähnliches Signal, kurzer Nachhall, kein Nahsprecher; ERLE = Dämpfung des
Echos nach Konvergenz):
| Echo-Verzögerung | AEC3 allein | AEC3 + Bulk-Delay-Kompensation |
|---|---|---|
| 0,05 s | 32,1 dB | 32,2 dB |
| 0,20 s | 31,4 dB | 32,3 dB |
| 0,40 s | 39,6 dB | 39,7 dB |
| 0,60 s | 10,5 dB | 40,0 dB |
| 0,80 s | 9,9 dB | 40,0 dB |
| 1,20 s | 9,8 dB | 40,3 dB |
| 1,80 s | 9,4 dB | 40,5 dB |
Ab etwa 0,5 s versagt AEC3 allein; übrig bleiben ca. 10 dB aus der
Nachunterdrückung. Netzwerkkameras liegen deutlich darüber (C200: ~1,8 s).
JuStAI verschiebt die Referenz deshalb selbst um die gemessene Verzögerung und
überlässt AEC3 nur noch den Rest (10 ms). Die Verzögerung schätzt
DelayEstimator laufend per GCC-PHAT aus Mikrofon und Referenz (nur Schätzungen
mit ausreichender Konfidenz, Median der letzten 7).
Echte Räume mit Nachhall, Nichtlinearitäten billiger Lautsprecher und schwankender Netzwerklatenz erreichen weniger. Deshalb bleibt Schicht 2 (Gating) die Grundsicherung, und Full Duplex wird nur nach Messung aktiviert.
Duplex-Modi
Abschnitt betitelt „Duplex-Modi“| Modus | Verhalten |
|---|---|
half |
Im Echo-Fenster wird das Mikrofon komplett verworfen. Kein Barge-in während der Ausgabe. Sicher mit jedem Gerät. |
full |
AEC aktiv, Mikrofon bleibt offen. Barge-in über Double-Talk-Erkennung. Nur für Geräte mit echtem Full-Duplex-Audio und gutem Echo-Abstand. |
auto (Standard) |
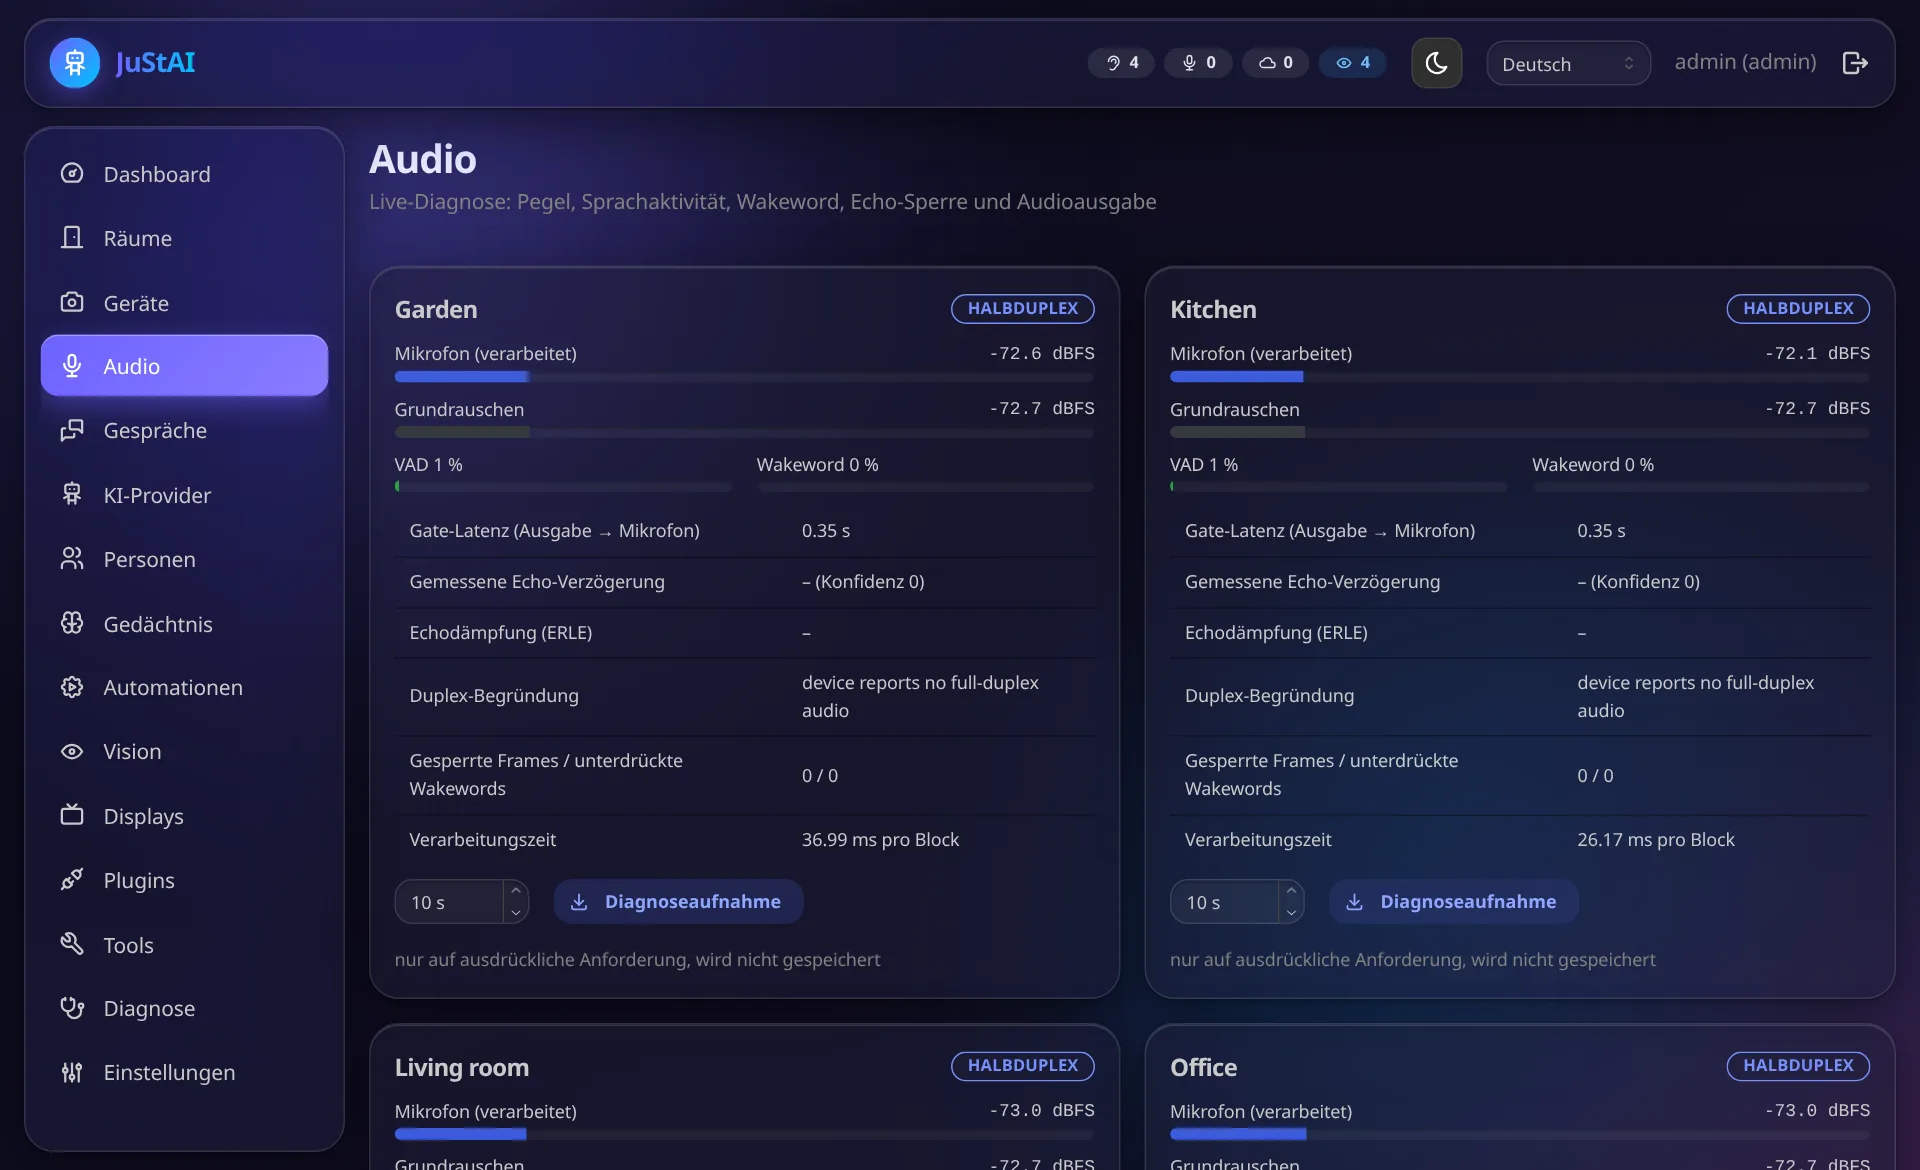
Startet als half. Wechselt zu full nur, wenn das Gerät audio.full_duplex meldet, die Verzögerung gemessen ist und die gemessene Echodämpfung (Median über ≥ 200 Frames) mindestens 18 dB beträgt. Der Grund steht in der Audio-Diagnose (duplex_reason). |
Barge-in (Full Duplex): Die AEC-Nachunterdrückung dämpft auch die Stimme des
Benutzers während Double-Talk. Die Erkennung arbeitet deshalb auf dem Rohsignal:
Mikrofonpegel minus erwarteter Echopegel (Referenzenergie + gemessene
Raumkopplung). Liegt der Pegel ≥ 8 dB darüber (mit VAD ≥ 0,5, sonst ≥ 14 dB) für
rund zwei Drittel von barge_in_min_speech_ms, gilt das als Unterbrechung. Die
Ausgabe stoppt sofort, der Tracker kürzt das Echo-Fenster, und die Session hört zu.
Echo allein löst im Test nie einen Barge-in aus.
Kalibrierung
Abschnitt betitelt „Kalibrierung“Admin-UI → Endpoints → Kalibrieren (POST /api/endpoints/{id}/calibrate):
drei Sweeps (400–3200 Hz) über den Lautsprecher, Aufnahme über das Mikrofon,
Auswertung per GCC-PHAT. Ist die Korrelation zu schwach, wird der
Einschwing-Zeitpunkt (Onset) mit Konsensprüfung über alle Sweeps verwendet.
Ergebnisse und ihre Deutung:
echo delay measured: Verzögerung wird als Startwert gesetzt.- Kein Echo am Mikrofon: Das Gerät schaltet sein Mikrofon während der Wiedergabe stumm (Hardware-Half-Duplex, z. B. Tapo C200). Das ist sicher; die konservative Standardlatenz bleibt aktiv.
- Echo hörbar, aber nicht messbar: Half Duplex beibehalten.
Ohne Kalibrierung nimmt das System für Netzwerkgeräte konservativ 2,2 s Latenz an, für lokale Geräte 0,35 s. Die tatsächlich verwendete Latenz ist nie kleiner als die gemessene Verzögerung + 0,15 s.
VAD und Äußerungsende
Abschnitt betitelt „VAD und Äußerungsende“Silero-VAD (ONNX) auf dem verarbeiteten Signal. Sprache beginnt nach 3
aufeinanderfolgenden Frames über vad_threshold (30 ms) und endet nach 300 ms
darunter. Das Ende einer Äußerung im Pipeline-Modus bestimmt
end_of_utterance_silence_ms (Standard 700 ms), Höchstlänge max_utterance_s.
Im Realtime-Modus übernimmt der Provider die Turn-Erkennung; JuStAI schickt
dabei nur nicht-gegatete Frames.
Wakeword
Abschnitt betitelt „Wakeword“openWakeWord 0.6.0 (ONNX), Schwelle 0,8 pro Endpoint (Standard), Refraktärzeit 1,5 s. Auswahl: Räume → Endpoint bearbeiten → Wakeword (mehrere gleichzeitig möglich).
Mitgeliefert: Hey Justy (hey_justi, Standard), Hey Jarvis, Alexa,
Hey Mycroft und Hey Rhasspy. „Hey Justy“ ist mit synthetischen englischen und
deutschen Stimmen trainiert und reagiert auf „Hey Justy“ und „Hey Justi“. Es ist
empfindlicher als die anderen Modelle, deshalb ist die Standard-Schwelle 0,8 (nur senken,
wenn es nicht reagiert). Die anderen sind auf Englisch trainiert und funktionieren genauso
gut, wenn der Rest des Gesprächs Deutsch oder Italienisch ist; für sie ist 0,5 ein guter
Start. Mischt man Modelle in einem Endpoint, gilt die Schwelle für alle.
Eigene Wakewords (z. B. „Hey Justi“): Ein openWakeWord-Modell trainieren (Anleitung und
Skripte: tools/wakeword, nur CPU, kein Colab nötig), dann die .onnx-Datei im selben Tab mit Eigenes Wakeword
hochladen installieren. Der Dateiname wird zur ID (hey_justi.onnx → hey_justi).
Der Core prüft, ob es wirklich ein openWakeWord-Klassifikator ist (Eingang
[1, n, 96], Ausgang [1, 1]), und legt ihn im Volume /data/wakewords ab, sodass
er Updates übersteht. Eigene Modelle lassen sich löschen
(DELETE /api/ai/wakewords/<id>), solange kein Endpoint sie nutzt.
Zuhören pausieren: „Hör im Schlafzimmer eine Stunde nicht zu“ schaltet das Wakeword
der Endpoints im Raum ab (audio.listening); eine einmalige Automation schaltet es
wieder ein (DEVICES.md). Bleibt eine Kamera
stumm: „Verbinde die Kamera im Büro neu“ (devices.reconnect) und „Teste den
Lautsprecher im Büro“ (devices.test_speaker).
Raumbewusste Wakeword-Arbitrierung
Abschnitt betitelt „Raumbewusste Wakeword-Arbitrierung“audio/arbitration.py. Mehrere Mikrofone hören dasselbe Wakeword. Kandidaten aus
derselben Arbitrierungsgruppe, die innerhalb von 0,8 s eintreffen, werden
gesammelt, bewertet, und genau einer gewinnt. Ein zuverlässiger Raum ist wichtiger
als die schnellste Aktivierung.
score = 10·wake_score + 0.25·clamp(SNR_phrase, −10, 70) + 2·VAD + priority − 3 (falls während eigener Wiedergabe) + 100 (falls dort schon eine Session läuft)- SNR der Phrase: 90. Perzentil der Rohpegel der letzten 1,2 s (das ist das Wakeword selbst, nicht die Pause danach) minus Roh-Rauschboden. Die Rauschunterdrückung würde den echten Abstand verfälschen. Lautstärke ist der beste Hinweis auf Nähe und dominiert bewusst kleine Unterschiede in der Wakeword-Konfidenz.
- Späte Duplikate: Mikrofone hinter unterschiedlichen Netzwerkpfaden liefern
dieselbe Äußerung unterschiedlich spät. Kandidaten anderer Endpoints derselben
Gruppe, die innerhalb von 2 s nach einer Entscheidung eintreffen, werden verworfen
(
audio.wakeword.rejected). Ein späteres, echtes Wakeword wird akzeptiert. - Endpoints in verschiedenen Gruppen werden unabhängig entschieden: Parallele Gespräche sind möglich.
Events: audio.wakeword.detected (jeder Kandidat), audio.wakeword.accepted
(mit Scores aller Kandidaten), audio.wakeword.rejected.
Sprechen ohne Pause nach dem Wakeword
Abschnitt betitelt „Sprechen ohne Pause nach dem Wakeword“„Hey Justy, wie spät ist es?“ in einem Atemzug funktioniert. Zwischen Erkennung und bereiter Session vergehen 1,4–1,7 s (gemessen: Arbitrierungsfenster 0,8 s, Sessionaufbau 0,55–0,9 s inkl. Verbindung zu Gemini Live). Damit diese Worte nicht verloren gehen:
- Jeder Endpoint hält die letzten 10 s verarbeitetes Audio (
EndpointAudio.recent). - Ist die Session bereit, bekommt sie zuerst das gepufferte Audio ab dem Wakeword,
dann live weiter (ohne
awaitdazwischen: kein Frame fehlt oder kommt doppelt). - Wo das Gesagte beginnt, entscheidet die Sprachaktivität (
replay_start):- Pause (≥ 150 ms unter der Sprachschwelle innerhalb von 0,8 s nach der Erkennung): ab der Pause; der Nachhall von „Jarvis“ bleibt draußen.
- Keine Pause: ab 0,15 s vor der Erkennung. openWakeWord meldet gemessen 0,04–0,27 s nach dem Ende von „Hey Justy“, also oft schon während des ersten Wortes der Frage; so bleibt es erhalten.
- Die Pipeline startet keine Erkennung für „Äußerungen“ mit weniger als 200 ms Sprache (Klicks, Hall). Sonst wäre die Session während der unnötigen Spracherkennung taub für die eigentliche Frage.
Getestet: tests/unit/test_wake_replay.py, tests/audio/test_wake_replay.py
(echtes openWakeWord, Piper-Stimme: mit und ohne Pause), E2E
test_question_right_after_the_wakeword_without_a_pause in Pipeline- und
Realtime-Modus (vorher fehlgeschlagen: die Frage ging verloren).
Getestet
Abschnitt betitelt „Getestet“backend/tests/unit/test_echo_blocks.py,test_wake_arbitration.py,test_calibration.py: Bausteine (Referenzpuffer, GCC-PHAT, Tracker, Arbitrierung inkl. später Duplikate, Onset-Kalibrierung).backend/tests/audio/test_self_speech.py(echte Modelle: Piper, openWakeWord, Silero): Der Assistent sagt absichtlich „Hey Jarvis“ in seiner Antwort; die Ausgabe kommt über einen simulierten Raum (Netzwerkverzögerung, Hall, Rauschen, optional Tapo-artiges Ducking) zurück.- Half Duplex Tapo-artig, Half Duplex mit lautem Echo ohne Ducking: kein Selbst-Wake, kein durchgelassenes Echo, das echte Wakeword danach wird erkannt.
- Unterschätzte Latenz wird durch Messung korrigiert.
- Full Duplex: AEC unterdrückt Selbst-Wake, echter Barge-in wird erkannt; Echo allein löst nie Barge-in aus.
- E2E (
backend/tests/e2e): Gespräch über simulierte Geräte mit Echo, keine Echo-Turns im Transkript, Arbitrierung zwischen zwei Räumen. - Echte Hardware (Tapo C200): Wakeword → Antwort über den Kameralautsprecher, kein Echo-Loop, Ende durch Inaktivität. Barge-in mit der C200 ist wegen des Hardware-Duckings nicht möglich und wurde nicht getestet.