Räume, Interaction Endpoints und Output Router
Begriffe
Abschnitt betitelt „Begriffe“| Begriff | Bedeutung |
|---|---|
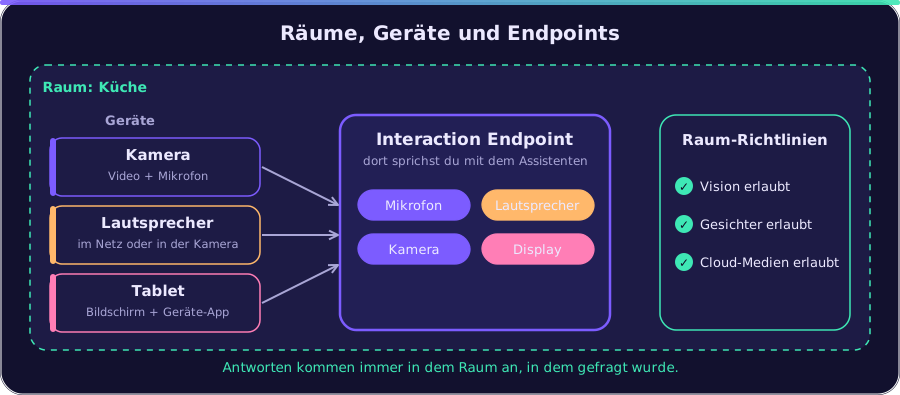
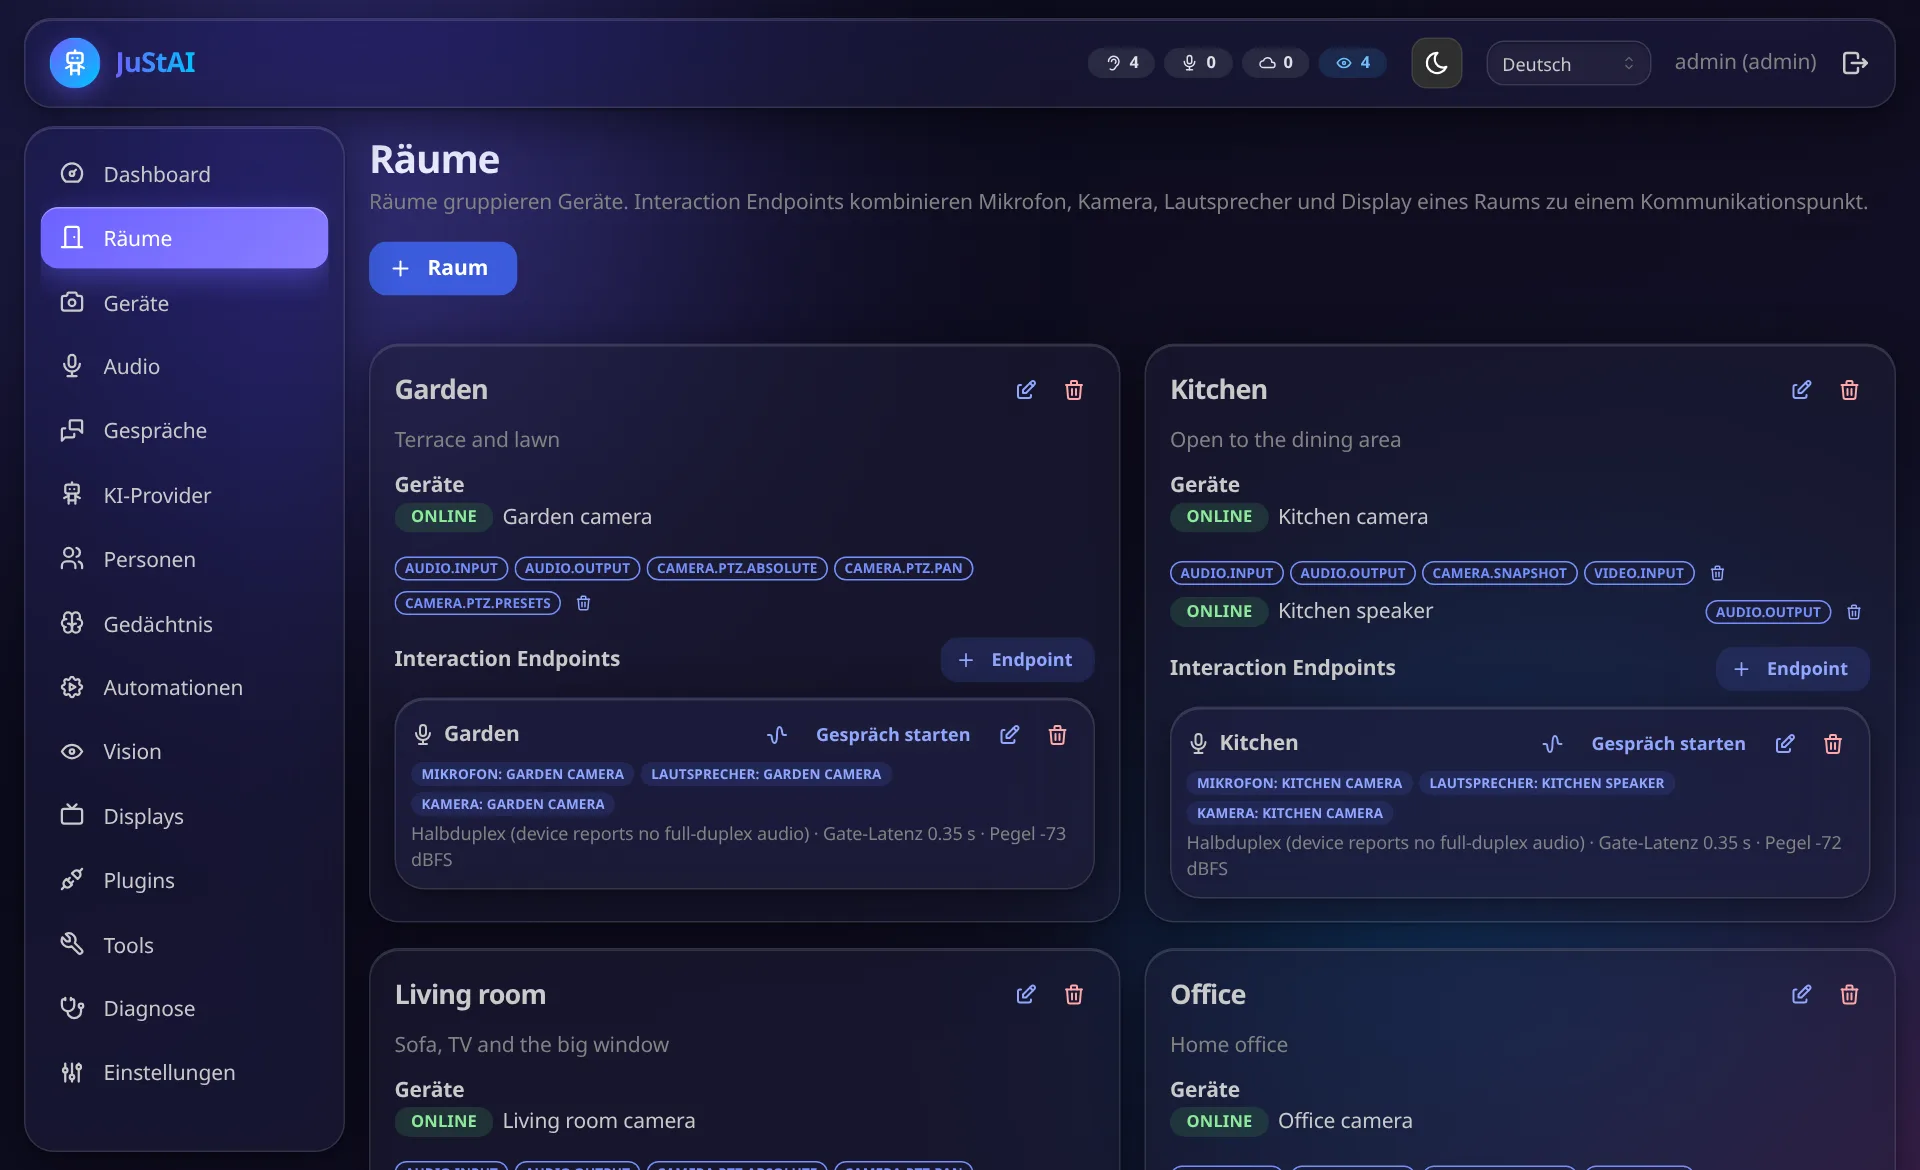
| Raum | physischer Bereich (Wohnzimmer, Küche). Geräte und Endpoints gehören zu genau einem Raum. |
| Gerät | Kamera, Mikrofon, Lautsprecher, Display … mit ermittelten Fähigkeiten (DEVICES.md) |
| Interaction Endpoint | konkrete Stelle, an der man mit dem Assistenten spricht: kombiniert unabhängige Geräte in Rollen mic, speaker, camera, display |
| Arbitrierungsgruppe | Endpoints, die dasselbe Wakeword gleichzeitig hören können (z. B. offene Wohnküche). Pro Gruppe gewinnt genau einer (AUDIO.md). |
Ein Endpoint kann z. B. das Mikrofon einer Tapo-Kamera, einen Netzwerklautsprecher und einen Fernseher kombinieren. Ein Gerät kann in mehreren Endpoints vorkommen (der Mikrofonkanal wird geteilt).
Raum-Richtlinien (policy)
Abschnitt betitelt „Raum-Richtlinien (policy)“| Feld | Standard | Wirkung |
|---|---|---|
shared_space |
true | persönliche Inhalte werden auf Displays hier nicht gezeigt |
vision_allowed |
true | Kameras in diesem Raum werden analysiert |
face_recognition_allowed |
true | Gesichtserkennung in diesem Raum |
cloud_media_allowed |
true | Bilder/Audio aus diesem Raum dürfen an Cloud-KI |
announcements_allowed |
true | Raum akzeptiert Durchsagen aus anderen Räumen |
Endpoint-Konfiguration
Abschnitt betitelt „Endpoint-Konfiguration“Modell: backend/src/justai/endpoints/service.py.
wakeword: enabled: true models: [hey_justi] threshold: 0.8 threshold_during_playback: 0.85 # nur Full Duplexaudio: duplex: auto # auto | half | full aec: true noise_suppression: true output_latency_ms: null # wird durch Kalibrierung gemessen echo_tail_ms: 600 input_gain_db: 0 vad_threshold: 0.5 barge_in: true barge_in_min_speech_ms: 300conversation: mode: default # default (globale Einstellung) | realtime | pipeline inactivity_timeout_s: 10 end_of_utterance_silence_ms: 700 max_utterance_s: 30 voice: null default_role: resident # Rechte anonymer Sprecher an diesem Endpoint follow_up_listening: true send_video: false # Kamerabilder an Realtime-Provider, die das können resume_window_s: 300 # neues Wakeword innerhalb 5 min setzt das letzte Gespräch fort (0 = nie) speaker_check: true # ... aber nur, wenn Stimme/Kamera nicht auf eine andere Person deutenGespräche fortsetzen
Abschnitt betitelt „Gespräche fortsetzen“Endet ein Gespräch durch Inaktivität und fällt innerhalb von resume_window_s wieder
das Wakeword am selben Endpoint, knüpft der Assistent an das letzte Gespräch an (der
bisherige Verlauf steht im Kontext). Nicht fortgesetzt wird, wenn …
- das Gespräch bewusst beendet wurde („Tschüss“, Admin),
- die Kamera des Endpoints jetzt eine andere erkannte Person sieht als vorher,
- die Stimme im Wakeword klar nicht zur Stimme des letzten Gesprächs passt.
Der Stimmvergleich nutzt ein Sprecher-Modell (WeSpeaker ResNet34). Die Stimm-Fingerabdrücke existieren nur im Arbeitsspeicher, werden keiner Person zugeordnet und nach Ablauf des Fensters verworfen; aufgezeichnete Sprache wird nach dem Berechnen sofort gelöscht. Messwerte: gleiche Stimme 0,68–0,82, andere Stimme 0,26–0,34 (Schwelle 0,45; auch in 8-kHz-Kameraqualität). Ist kein Vergleich möglich (z. B. zu wenig Sprache), wird innerhalb des Fensters fortgesetzt.
Zu Beginn jedes Gesprächs übernimmt der Assistent außerdem die Person, die die Kamera des Endpoints in der letzten Minute als Einzige erkannt hat („Du sprichst mit Julian“).
Weitere Felder: room_id, arbitration_group (Standard default), priority, language, enabled.
Output Router
Abschnitt betitelt „Output Router“backend/src/justai/output/router.py ist die einzige Stelle, die entscheidet,
welches Gerät ausgeben darf. Die Regeln sind deterministisch und werden nie an
das Sprachmodell delegiert:
- Ausgaben gehen in den Raum der auslösenden Interaktion. Der Raum des Endpoints hat Vorrang vor jeder anderswo behaupteten Raumangabe.
- Ein anderer Zielraum braucht drei Dinge: eine explizite Cross-Room-Anfrage
(nur Tools wie
conversation.announcesetzen sie), das Rechtoutput.cross_roomund einen Zielraum mitannouncements_allowed. - Ein explizit angefragtes Gerät muss im Zielraum stehen, online sein und die nötige Fähigkeit haben.
- Audio bevorzugt den Lautsprecher des auslösenden Endpoints. Ersatz ist ein anderer Lautsprecher desselben Raums, nie ein anderer Raum.
- Persönliche Inhalte erscheinen nicht auf Displays in
shared_space-Räumen, außer es ist ausdrücklich erlaubt. - Offline-Geräte werden nie gewählt. Ist nichts verfügbar, schlägt die Ausgabe
mit
RoutingDeniedfehl, statt still in einen anderen Raum auszuweichen. - Ausgaben ohne Ursprungsraum (z. B. Testtöne aus der Admin-UI) sind nur für Admins erlaubt.
Jede Entscheidung enthält Begründungen (reasons), die im Log und in der
Diagnose sichtbar sind.
Bindung von Gesprächen an ihren Raum
Abschnitt betitelt „Bindung von Gesprächen an ihren Raum“Eine Gesprächssession gehört genau einem Endpoint. Jede Audioausgabe der Session
(Antworten, Tool-Ergebnisse, Bestätigungsfragen, Fehlerhinweise) fragt den
Output Router mit origin_endpoint_id der Session. Das gilt auch:
- nach langen Tool-Aufrufen und Wartezeiten,
- nach Reconnects oder Fallbacks des KI-Providers,
- wenn Automationen eine Session starten: Raum = Raum des auslösenden Events
(
room: trigger) oder ein explizit konfigurierter Raum.
Verifiziert durch die E2E-Tests (backend/tests/e2e/test_simulated_rooms.py):
Die Antwort erscheint nur am Lautsprecher des Wohnzimmers, der Küchenlautsprecher
bekommt kein einziges Audio-Frame.
Parallele Gespräche
Abschnitt betitelt „Parallele Gespräche“Endpoints in verschiedenen Arbitrierungsgruppen können gleichzeitig eigene Sessions haben. Jede Session hat eigenen Zustand, eigene Historie und eigene Ausgabe. Im E2E-Test fragen zwei Räume parallel „2+2“ und „3+3“, und jeder Raum bekommt seine eigene Antwort.