Langzeitgedächtnis
Code: backend/src/justai/memory/. Speicherung in PostgreSQL, semantische Suche
über pgvector (Embeddings 384 Dim., lokal mit fastembed
paraphrase-multilingual-MiniLM-L12-v2).
Gedächtnisarten
Abschnitt betitelt „Gedächtnisarten“| Art | Inhalt | Wo |
|---|---|---|
| Arbeitsgedächtnis | laufender Gesprächskontext (max. 30 Nachrichten) | nur in der Session |
episode |
Zusammenfassungen vergangener Gespräche/Ereignisse | Tabelle memories |
fact |
Fakten („Der Kellerschlüssel liegt in der blauen Dose“) | |
preference |
Vorlieben („Julian mag Antworten kurz“) | |
procedure |
gelerntes Verhalten (Automationen verweisen darauf) | |
note |
freie Notizen aus der Admin-UI |
Zusätzlich sind Transkripte (transcript_turns), Sichtungen und Events eigene,
zeitlich begrenzte Speicher (SECURITY.md).
Herkunft (Provenance)
Abschnitt betitelt „Herkunft (Provenance)“Jede Erinnerung trägt ihre Herkunft, und der Assistent bekommt sie mitgeteilt:
| Provenance | Bedeutung | im Prompt |
|---|---|---|
confirmed |
ausdrücklich gesagt oder bestätigt | „bestätigt“ |
observed |
von Kameras/Sensoren beobachtet | „beobachtet“ |
extracted |
aus einem Gespräch extrahiert | „aus Gespräch“ |
inferred |
Vermutung eines Modells | „VERMUTUNG“ |
Dazu kommen confidence, importance, access_count, last_accessed_at und eine
Quelle (Session, Tool, Event).
Sichtbarkeit (scope)
Abschnitt betitelt „Sichtbarkeit (scope)“private: gehört einer Person (owner_person_id) und ist nur sichtbar, wenn diese Person als Sprecher erkannt ist.room: nur in einem Raum relevant.shared: Wissen des Haushalts.system: vom System gepflegt.
Ein unbekannter Sprecher sieht nur shared, system und room für seinen Raum.
Extraktion aus Gesprächen mit unbekanntem Sprecher speichert als shared.
-
Abruf (Recall): Vor jeder Antwort sucht die Session passende Erinnerungen (Vektorsuche, Mindestähnlichkeit 0,25, Ergänzung per Stichwortsuche) und gibt sie mit Herkunft und Datum in den Prompt. Ist die Person bekannt, kommen Erinnerungen über sie dazu.
-
Explizit merken: Tool
memory.remember(„Merk dir …“) →confirmed. -
Extraktion: Nach Gesprächsende extrahiert ein Job (
memory.extract, Rollememoryim KI-Router) Fakten und Vorlieben aus dem Transkript (extracted). Gespräche mit weniger als 15 Zeichen Benutzertext werden übersprungen. -
Duplikate: Beim Speichern wird eine Erinnerung mit ≥ 0,92 Ähnlichkeit (gleicher Besitzer) zusammengeführt statt dupliziert.
-
Konsolidierung (täglich, Job
memory.consolidate, auch manuell in der Admin-UI):- fast gleiche Erinnerungen zusammenführen (die mit höherer Herkunft bzw. neuere bleibt),
- widersprüchliche Fakten (gleiches Subjekt/Prädikat/Besitzer): die neueste
bleibt aktiv, ältere werden
superseded(mit Verweis), nicht gelöscht, - nie abgerufene Vermutungen (
inferred) nach 90 Tagen löschen.
-
Vergessen: Tools
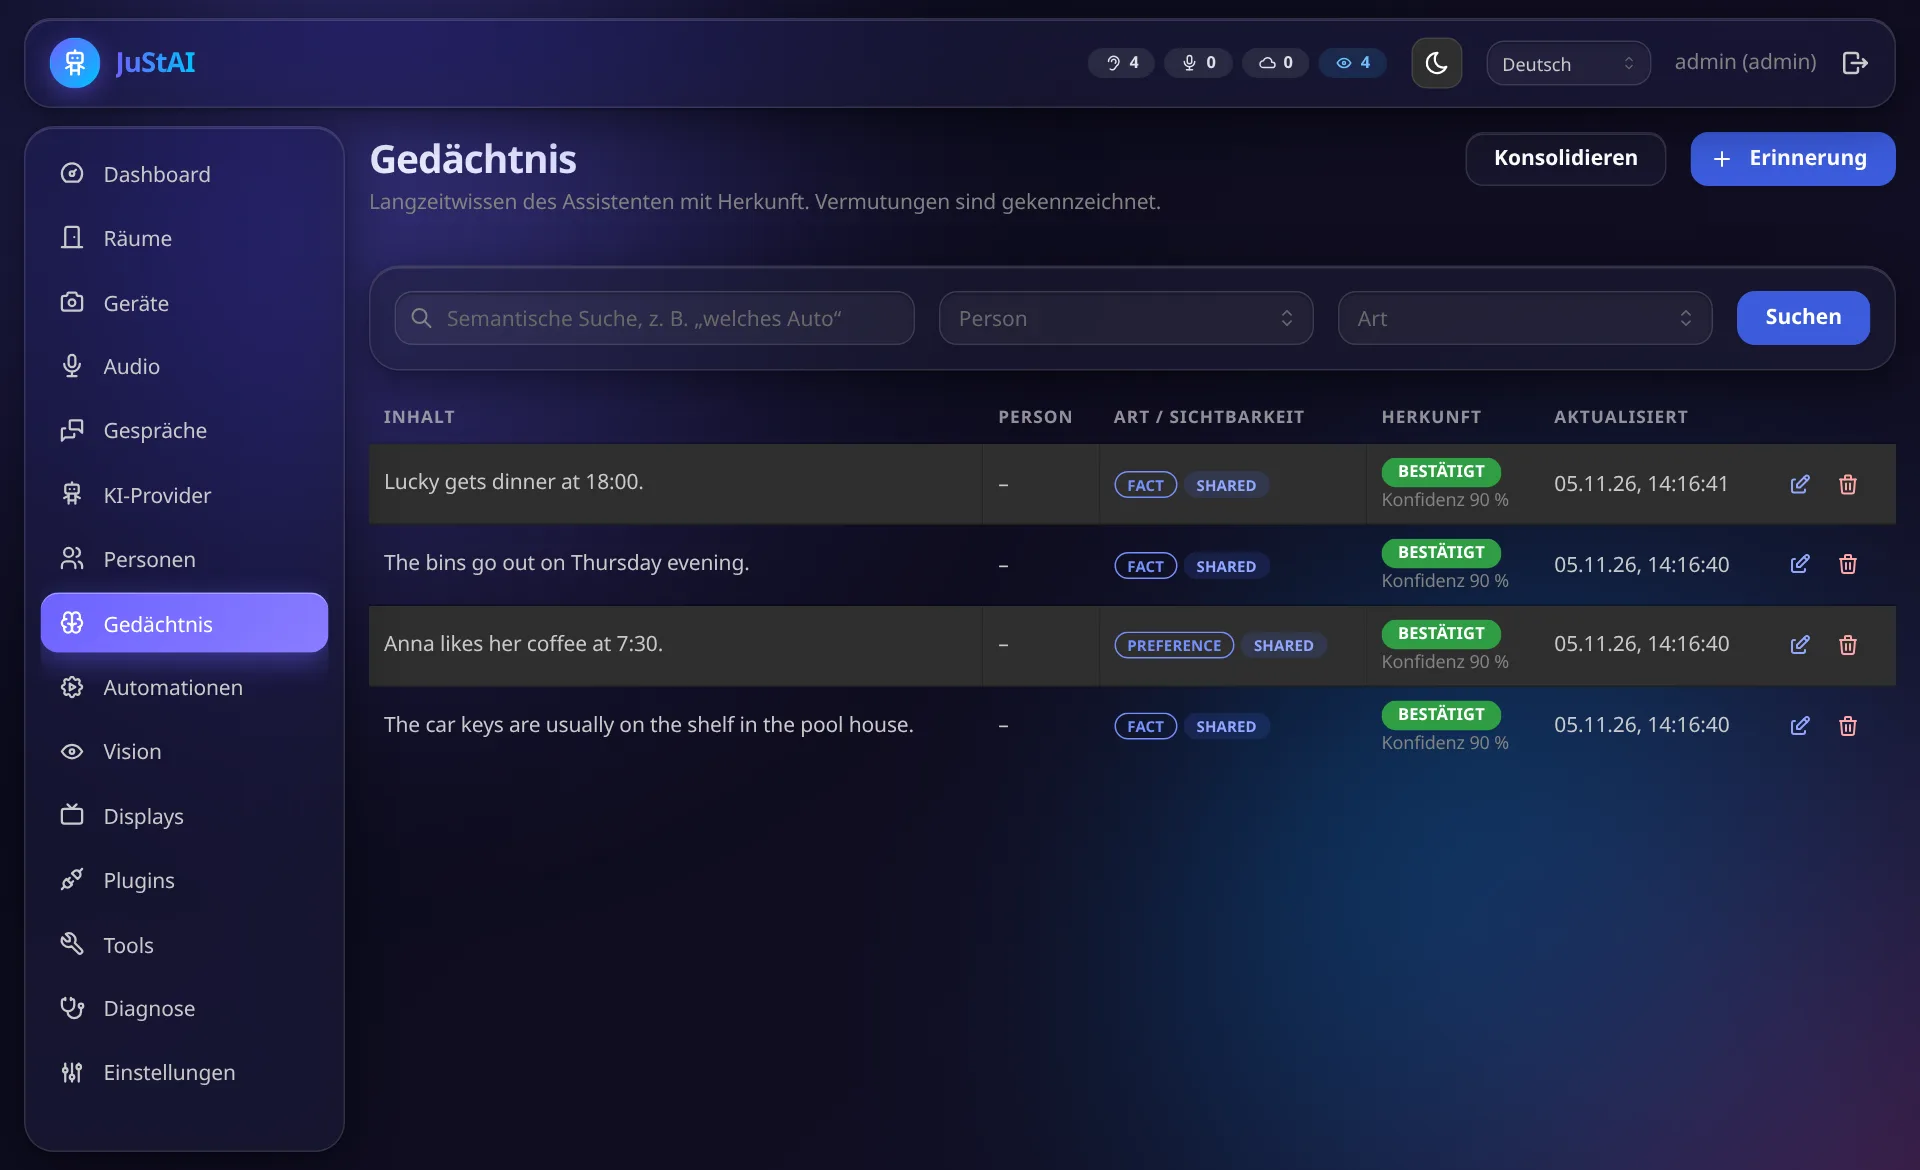
memory.find_to_forget+memory.forget. Das Löschen verlangt eine Bestätigung im Gespräch. In der Admin-UI (Gedächtnis) lässt sich alles ansehen, suchen, bearbeiten und löschen.Vergessen ist dauerhaft. Der Inhalt wird gelöscht; zurück bleibt nur ein Grabstein mit dem Embedding (ohne Text). So kann die spätere automatische Extraktion aus dem Transkript eines älteren Gesprächs die Information nicht wiederherstellen: Ähnliche Fakten (≥ 0,85) werden verworfen, und die Zusammenfassung dieses Gesprächs entfällt. Nur eine ausdrückliche Bitte („Merk dir …“) hebt die Sperre wieder auf. Gefunden wurde das in einem Live-Test: Ohne diese Sperre tauchte ein vergessener Fakt nach dem Ende der ursprünglichen Session wieder auf.
Hinweis: Die Transkripte selbst sind ein eigener Speicher mit eigener Aufbewahrungsfrist (Standard 365 Tage, Einstellungen → Aufbewahrung). Vergessen löscht nur das Gedächtnis, nicht das Transkript.
Datenschutz
Abschnitt betitelt „Datenschutz“- Erinnerungen gehen nur an Cloud-Modelle, wenn
personal_memories_to_clouderlaubt ist. Sonst muss die Rollememorybzw.conversationlokal laufen. - Löschen einer Person löscht ihre privaten Erinnerungen mit.
Getestet
Abschnitt betitelt „Getestet“Gegen die laufende Docker-Instanz (Gemini als LLM, fastembed lokal):
- „Merk dir bitte: Der Ersatzschlüssel für den Keller liegt in der blauen Dose im
Flur.“ → gespeichert als
fact,shared,confirmed. - In einer neuen Session: „Wo liegt der Ersatzschlüssel für den Keller?“ → richtige Antwort aus dem Gedächtnis.
- „Vergiss bitte, wo der Ersatzschlüssel liegt.“ → Rückfrage, nach „Ja“ gelöscht.
- Live nach der Korrektur: „Merk dir: Der Code für das Gartentor ist 4711“ →
„Vergiss den Code“ → beide Sessions beendet → die Extraktion verwirft den
Fakt (
skipped_forgotten: 1), das Gedächtnis bleibt leer.
Automatisiert (backend/tests/db/test_memory_forget.py, echte PostgreSQL mit
pgvector, deterministische Test-Embeddings): Vergessenes wird nicht re-extrahiert,
ist unsichtbar und textfrei; ausdrückliches Merken hebt die Sperre auf; anderes
wird weiterhin extrahiert. Für Konsolidierung gibt es noch keinen
automatisierten Test.